前回の記事では、プログラミング未経験の状態からChatGPTを使って日本株の投資支援ツールを作り、
- 株価データの取得
- RSI・MACDなどのテクニカル指標の計算
- 複数銘柄への対応
- 流動性による銘柄の絞り込み
- 条件に応じたスコアリング
まで進めた過程を紹介しました。
ここまで作ると、銘柄ごとにスコアが表示され、「買い候補」「売り候補」を機械的に絞り込めるようになります。
ただ、実際に画面を見ていて一つ大きな疑問が出てきました。
「この売買ルール、本当に利益が出るのか?」
RSIやMACD、移動平均線などを組み合わせれば、それらしい売買シグナルを作ること自体はできます。
しかし、それが過去の相場でも有効だったのかは別問題です。
そこで次に作り始めたのが、バックテスト機能でした。
株のバックテストとは?
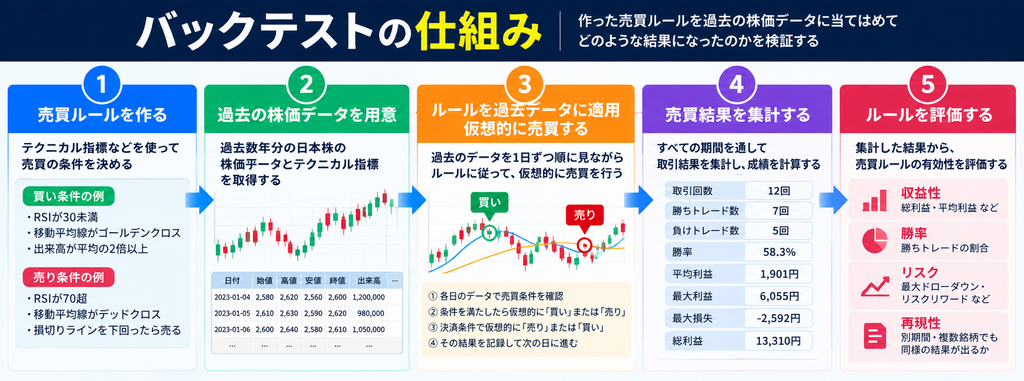
バックテストとは、簡単に言えば、
「作った売買ルールを過去の株価データに当てはめて、どのような結果になったのかを検証すること」
です。
例えば、
「RSIが一定以下になったら買う」
「移動平均線がゴールデンクロスしたら買う」
といったルールを作ったとします。
ルールを作っただけでは、それが本当に有効なのか分かりません。
そこで過去数年分の株価データを使い、
「この条件で実際に売買していたらどうなっていたのか?」
を調べます。
これがバックテストです。
なぜバックテストを作ろうと思ったのか
今回作っている投資支援ツールでは、複数のテクニカル指標を組み合わせて銘柄を評価しています。
例えば、
- RSI
- MACD
- 移動平均線
- ボリンジャーバンド
- 出来高
- ADX
などです。
それぞれの条件に応じて点数を加点・減点し、最終的に銘柄をスコアリングします。
仕組みだけを見ると、それなりに投資ツールらしくなってきました。
しかし、
「複雑な仕組み=利益が出る仕組み」ではありません。
実際のトレードでもChatGPTを使ってチャート分析などをしていますが、チャートの読み取りや前提条件を誤った回答が出ることもあります。
トレードする際の一つの意見としては非常に参考になる一方、スピードが重要なデイトレでは、その都度間違いを指摘して修正している余裕はありません。
今回ツールに組み込んでいるテクニカル指標やその組み合わせも、もともとはChatGPTから提案されたものです。
そのため、
「この条件をそのまま使って、本当に勝てるのか?」
という疑問は最初からありました。
ChatGPTが提案したロジックをそのまま信用するのではなく、実際の過去データで検証してみたい。
これがバックテストを作ろうと思った大きな理由の一つです。
Pythonでバックテスト機能を作ってみる
今回のバックテストでは、過去の株価データを取得し、そのデータに対して売買ルールを適用する仕組みを作りました。
最終的には、
- 取引回数
- 勝ちトレード数
- 負けトレード数
- 勝率
- 平均利益
- 最大利益
- 最大損失
- 総利益
などを確認できるようにします。
私はプログラミング経験がないため、ここでもChatGPTに相談しながらコードを追加していきました。
コードを追加し、いよいよバックテストを実行します。
ところが――
当然のように、一発では動きませんでした。
バックテストを実行したらエラーが発生
実行すると、次のエラーが表示されました。
KeyError: 'RSI_TREND'
プログラミング未経験の私には、最初は何が問題なのか分かりません。
そこでエラー内容をChatGPTに伝え、原因を一つずつ確認しました。
すると、問題はバックテストの計算式そのものではなく、読み込んでいるCSVデータにありました。
バックテストで使用しようとしている「RSI_TREND」という項目が、保存済みのCSVに存在していなかったのです。
必要な26列に対して、保存されていたのは11列
実際にCSVの中身を確認してみると、原因がはっきりしました。
バックテスト側では、
- RSI
- RSIのトレンド
- MACD
- MACDシグナル
- MACDヒストグラム
- ボリンジャーバンド
- ADX
など、複数の指標を使用するようになっていました。
ところが以前作ったCSVには、11列しか保存されていませんでした。
開発を進める中で分析機能には新しい指標を次々追加していましたが、過去データを保存するプログラム側がそれに追いついていなかったわけです。
これは実際に作ってみなければ気付きにくい部分でした。
過去データ生成処理を修正
そこで、過去データを作成しているプログラムを修正しました。
不足していたテクニカル指標を追加し、バックテストに必要なデータをすべてCSVへ保存するよう変更します。
その後、5年分の過去データを再生成。
もう一度列数を確認すると、
11列 → 26列
になりました。
これで必要なデータが揃いました。
そして、再びバックテストを実行します。
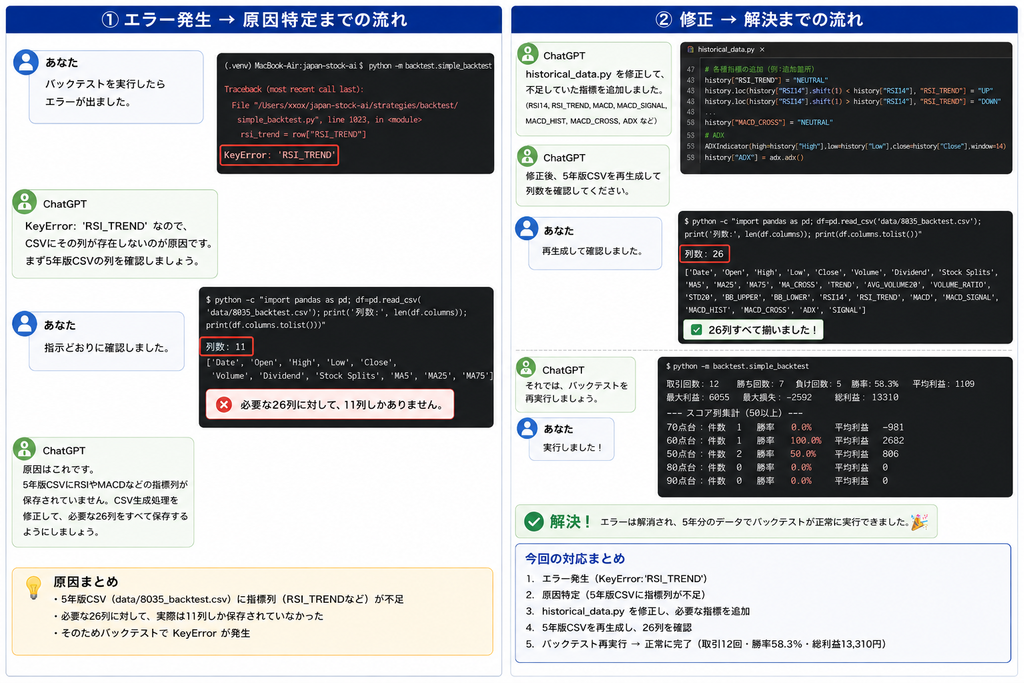
バックテストでエラーが発生してから、原因となったデータ不足を特定。過去データ生成処理を修正し、11列から26列へ拡張したうえで、5年分のデータを使ったバックテストを正常に実行できました。
実際のバックテスト結果
今回のテストでは、次のような結果になりました。
| 項目 | 結果 |
|---|---|
| 取引回数 | 12回 |
| 勝ち | 7回 |
| 負け | 5回 |
| 勝率 | 58.3% |
| 最大利益 | 6,055円 |
| 最大損失 | -2,592円 |
| 総利益 | 13,310円 |
一応、結果だけを見ればプラスです。
勝率も58.3%あります。
プログラミング未経験から作り始めたものが、実際に過去データを読み込んで売買結果を計算するところまで動きました。
ただ、結果を見たときの感想は、
「58.3%か……正直イマイチだな」
でした。
条件を調整していけば60〜70%くらいまで上げられるのか。
それとも条件を厳しくすると、今度は売買機会そのものが減ってしまうのか。
また、今回の取引回数はわずか12回です。
12回で58.3%だったものが、100回、1,000回と試行回数を増やしても同じくらいの勝率を維持できるのかも気になります。
とはいえ、最初のバックテストでは一応プラスになっています。
そのため、
「とりあえず現在の条件をベースに開発を先へ進めて、あとから条件を改善していけばいいのでは?」
とも思いました。
ただ、ここで一つ疑問が出ました。
「バックテストの結果を見てから、勝率が上がるように条件を変更していくやり方は、本当に正しいのか?」
勝率を上げるように条件を変更すればいいのか?
ここで注意したいのが、バックテストの結果を見ながら、勝率が高くなるまで条件を調整していくことです。
売買条件を改善して再検証すること自体は、今後の開発でも必要です。
しかし、同じ過去データを何度も使い、
「RSIを30から35にしたら勝率が上がった」
「この条件を追加したらさらに成績が良くなった」
という調整を繰り返していくと、その過去データだけで成績が良くなるルールを作ってしまう可能性があります。
いわゆる**「過学習(オーバーフィッティング)」**です。
さらに、今回のバックテストは取引回数が12回しかありません。
12回中7回勝ったという結果だけでは、条件そのものに優位性があるのか、それとも偶然なのかを判断するには不十分です。
そのため今後は、「勝率を60%、70%まで上げる」こと自体を目標にするのではなく、
- 取引回数
- 平均利益・平均損失
- リスクリワード
- プロフィットファクター
- 最大ドローダウン
- 複数銘柄での再現性
- 別期間のデータでも成績を維持できるか
なども含めて評価する必要がありそうです。
また、実際の売買では手数料やスリッページも発生するため、バックテスト上でプラスになっただけで実運用できるとは判断できません。
バックテストを作って分かったこと
今回バックテストを作ってみて感じたのは、売買ルールを作ることと、それが本当に有効なのかを検証することは別物だということです。
例えば、
「RSIが売られすぎだから買う」
というルールは簡単に作れます。
しかし、
「RSIはいくつ以下にするのか」
「何日保有するのか」
「どこで損切りするのか」
「利益確定はどうするのか」
「他の指標と組み合わせるのか」
によって結果は大きく変わります。
さらに、一つの銘柄で機能したルールが別の銘柄でも機能するとは限りません。
単純に「利益が出た・出なかった」だけを見るのではなく、検証方法そのものを改善する必要があります。
次に改善したいこと
現在のバックテストは、まだ初期段階です。
今後は、
- 複数銘柄での検証
- 取引回数を増やした検証
- スコア別の成績比較
- 最大ドローダウンの計算
- リスクリワードの検証
- プロフィットファクターの計算
- 手数料やスリッページの考慮
- 相場環境ごとの成績比較
- 別期間のデータを使った検証
なども追加したいと考えています。
特に、同じデータを見ながら条件を調整し続けるのではなく、
「条件を作るために使うデータ」と「完成した条件を評価するデータ」を分ける
といった検証方法も取り入れていく必要がありそうです。
そして、バックテストである程度有効性を確認できたルールについては、いきなり実資金を投入するのではなく、ペーパートレードで検証する段階へ進める予定です。
最終的には、
バックテスト → ペーパートレード → 半自動売買 → 自動売買
という順番で進めたいと考えています。
プログラミング未経験でもバックテストまでは作れた
今回の開発でも、エラーが発生しました。
しかも原因は、最初に疑ったバックテストのコードではなく、以前作った過去データの保存処理でした。
自分一人で開発していたら、原因を探すだけでもかなり時間がかかったと思います。
一方でChatGPTを使えば、
エラーを確認する
↓
原因候補を絞る
↓
確認方法を教えてもらう
↓
修正する
↓
もう一度実行する
という流れで進められます。
ただし、ChatGPTが生成したコードをそのまま信用するのではなく、実際に動かして結果を確認する作業は必要です。
これは投資判断についてChatGPTを使う場合も、プログラムのコードを作ってもらう場合も同じだと感じています。
AIに判断を丸投げするのではなく、使える部分は使いながら、間違っていないかを検証する。
今回のバックテスト開発も、その必要性を改めて実感する出来事になりました。
まとめ:バックテストが動いてからが本当の検証のスタート
プログラミング未経験から始めた日本株の投資支援ツールですが、今回は過去データを使って売買ルールを検証するバックテストまで実装できました。
最初の結果は、
12取引・勝率58.3%・総利益13,310円。
数字だけを見ると一応プラスです。
しかし、サンプル数は少なく、この結果だけで売買ルールが有効だとは判断できません。
また、勝率を上げようとして過去の結果に合わせて条件を調整しすぎれば、今度は過学習の問題が出てきます。
今回バックテストが動いたことで、ようやく、
「どうすれば本当に使える売買ルールなのかを検証できるか」
という次の段階に入ったと考えています。
今後も、うまくいった部分だけではなく、エラーや失敗、売買ルールを変更した結果なども含めて記録していきます。
最終的には、実際のトレードで利用できる投資支援ツール、そして証券APIと連携した自動売買まで発展させることが目標です。
追記:バックテスト開発はその後も続いています
この記事は、初めてバックテストが動いた段階の開発記録です。
この時点では12取引の小規模な検証でしたが、その後は複数銘柄への拡張や損切りルール、MFE・MAE、売買コストなど、より実運用に近い条件での検証へ進んでいます。
日本株AI投資支援ツールの開発全体と、その後の検証記事は以下にまとめています。
コメント